Pos

Enterprise Backup Readiness Checklist: Seberapa Siap Strategi Backup Perusahaan Anda?
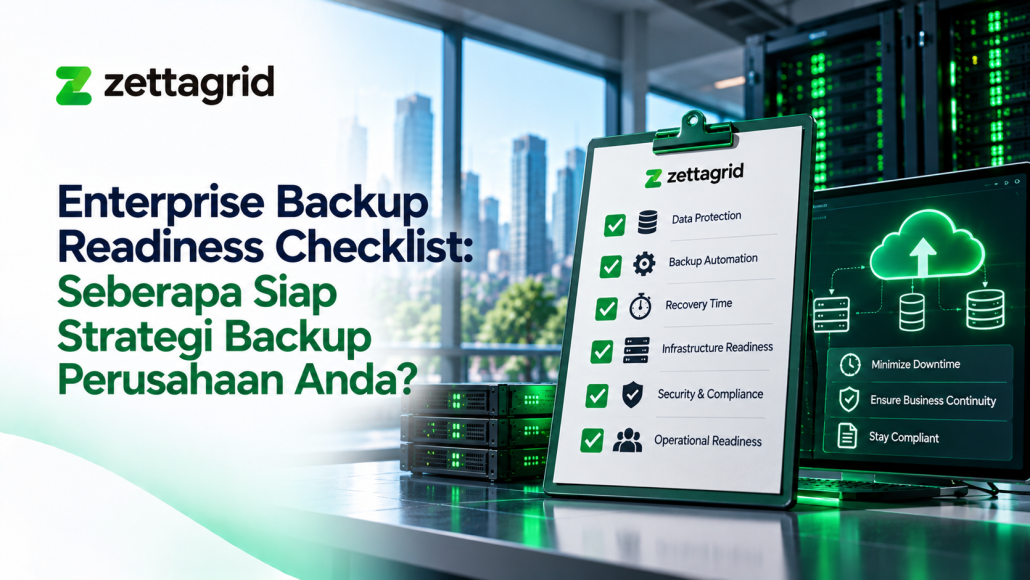
Ilustrasi Backup Automation untuk mengurangi human error dan mempercepat pemulihan data

Backup Automation membantu perusahaan mengurangi kesalahan manual dan meningkatkan efisiensi proses backup.

Banyak perusahaan percaya bahwa mereka sudah memiliki enterprise backup yang memadai karena job backup berjalan rutin dan dashboard menunjukkan status “sukses”. Namun, ketika disaster benar-benar terjadi, sering kali muncul kenyataan pahit: backup tidak dapat dipulihkan, recovery time jauh lebih lama dari ekspektasi, atau salinan backup ikut terenkripsi oleh ransomware. Backup readiness bukan hanya tentang memiliki backup, melainkan tentang memastikan bahwa backup tersebut benar-benar dapat diandalkan saat dibutuhkan.

Artikel ini menyediakan enterprise backup checklist praktis yang dapat digunakan oleh CIO, IT Director, dan tim infrastruktur untuk mengevaluasi kesiapan strategi backup saat ini. Checklist ini mencakup aspek teknis, operasional, dan governance yang sering kali terlewat dalam evaluasi tradisional.

Mengapa Checklist Backup Readiness Penting?

Tanpa kerangka evaluasi yang jelas, tim IT sering kali fokus pada metrik yang mudah diukur (seperti jumlah job backup sukses) daripada metrik yang benar-benar mencerminkan kesiapan recovery. Checklist yang komprehensif membantu mengidentifikasi gap sebelum insiden terjadi, memprioritaskan perbaikan berdasarkan risiko bisnis, dan memberikan dasar objektif untuk investasi tambahan dalam data protection strategy.

Di lingkungan ancaman siber modern, di mana ransomware secara aktif menargetkan backup repository, pertanyaan “apakah backup kita cukup?” perlu dijawab dengan evaluasi mendalam, bukan asumsi.

Checklist Evaluasi Enterprise Backup Readiness

Berikut adalah checklist terstruktur yang dapat digunakan untuk menilai kesiapan backup perusahaan Anda. Setiap bagian mencakup pertanyaan evaluasi dan indikator kesiapan.

1. Workload Coverage: Apa Saja yang Harus Dilindungi?

Pertanyaan Kunci:

  • Apakah semua server, virtual machine, database, dan aplikasi kritikal telah teridentifikasi dan tercakup dalam jadwal backup?
  • Apakah workload nontradisional (container, SaaS seperti Microsoft 365, workload cloud) juga dilindungi?
  • Apakah ada server “shadow IT” atau sistem warisan yang terlewat dari cakupan backup?

Indikator Kesiapan:

  • Inventory lengkap semua workload kritikal dengan owner dan criticality level yang jelas
  • Semua workload dalam inventory memiliki policy backup yang terdefinisi
  • Tidak ada sistem produksi yang berjalan tanpa perlindungan backup

Risiko Jika Tidak Terpenuhi:
Workload yang tidak ter-backup adalah blind spot yang dapat mengakibatkan kehilangan data permanen saat insiden terjadi.

2. Backup Frequency: Apakah RPO Sesuai Kebutuhan Bisnis?

Pertanyaan Kunci:

  • Berapa frekuensi backup untuk setiap workload (harian, per jam, continuous)?
  • Apakah frekuensi backup sesuai dengan RPO (Recovery Point Objective) yang disepakati dengan bisnis?
  • Apakah ada workload kritikal yang hanya di-backup sekali sehari atau lebih jarang?

Indikator Kesiapan:

  • RPO terdefinisi untuk setiap workload berdasarkan dampak bisnis
  • Frekuensi backup memenuhi atau melebihi target RPO
  • Backup dijadwalkan pada waktu yang meminimalkan dampak terhadap performa produksi

Risiko Jika Tidak Terpenuhi:
RPO yang terlalu longgar berarti lebih banyak data yang hilang saat recovery, yang dapat berdampak pada operasional dan kepatuhan regulasi.

3. Retention: Berapa Lama Data Disimpan?

Pertanyaan Kunci:

  • Apakah retention policy (harian, mingguan, bulanan, tahunan) telah didefinisikan untuk setiap workload?
  • Apakah retention memenuhi kebutuhan compliance dan regulasi industri?
  • Apakah ada backup yang disimpan terlalu lama (memboroskan storage) atau terlalu singkat (tidak memenuhi kebutuhan audit)?

Indikator Kesiapan:

  • Retention policy terdokumentasi dan diterapkan secara konsisten
  • Retensi jangka panjang (bulanan/tahunan) tersedia untuk workload yang memerlukan compliance
  • Review berkala dilakukan untuk memastikan retention masih relevan

Risiko Jika Tidak Terpenuhi:
Retensi yang tidak sesuai dapat menyebabkan kegagalan audit, ketidakmampuan memenuhi e-discovery, atau pemborosan biaya storage.

4. Backup Location: Apakah Ada Offsite Copy?

Pertanyaan Kunci:

  • Apakah backup disimpan hanya di lokasi yang sama dengan produksi, atau ada salinan offsite?
  • Apakah lokasi offsite memiliki jarak geografis yang cukup untuk melindungi dari bencana regional?
  • Apakah akses ke lokasi offsite terjamin saat diperlukan untuk recovery?

Indikator Kesiapan:

  • Minimal satu salinan backup disimpan di lokasi terpisah secara geografis
  • Lokasi offsite dapat diakses dalam waktu yang sesuai dengan RTO
  • Konektivitas dan bandwidth ke offsite telah diuji untuk skenario recovery

Risiko Jika Tidak Terpenuhi:
Tanpa offsite copy, bencana fisik (kebakaran, banjir, gempa) dapat menghapus produksi dan backup sekaligus.

5. Immutability: Apakah Backup Dapat Dilindungi dari Perubahan atau Penghapusan?

Pertanyaan Kunci:

  • Apakah ada salinan backup yang dilindungi dengan immutability (tidak dapat diubah atau dihapus selama periode tertentu)?
  • Apakah fitur immutability benar-benar aktif dan terkonfigurasi dengan benar?
  • Apakah ada backup yang sepenuhnya terisolasi (air-gapped) dari jaringan produksi?

Indikator Kesiapan:

  • Minimal satu salinan backup immutable untuk workload kritikal
  • Immutability diterapkan pada repository yang terpisah dari produksi
  • Akses ke backup immutable dibatasi dengan kontrol ketat dan MFA

Risiko Jika Tidak Terpenuhi:
Backup yang dapat dihapus atau diubah rentan terhadap ransomware, insider threat, atau human error yang dapat menghapus jalur recovery.

6. Access Control: Siapa yang Dapat Menghapus atau Mengubah Backup?

Pertanyaan Kunci:

  • Siapa saja yang memiliki akses administratif ke sistem backup?
  • Apakah prinsip least privilege diterapkan (akses hanya sesuai kebutuhan)?
  • Apakah MFA (Multi-Factor Authentication) diwajibkan untuk akses ke sistem backup?

Indikator Kesiapan:

  • Daftar admin backup terdokumentasi dan direview berkala
  • Akses administratif dipisahkan dari akses produksi
  • MFA diaktifkan untuk semua akun dengan privilege tinggi

Risiko Jika Tidak Terpenuhi:
Kredensial admin yang bocor dapat memungkinkan penyerang menghapus atau mengubah backup, menghilangkan jalur recovery.

7. Monitoring: Apakah Failed Job Segera Terdeteksi?

Pertanyaan Kunci:

  • Apakah ada dashboard terpusat yang menampilkan status semua backup job?
  • Apakah alert dikonfigurasi untuk job gagal, warning, atau anomali?
  • Siapa yang menerima alert dan berapa lama waktu respons yang diharapkan?

Indikator Kesiapan:

  • Dashboard real-time menampilkan status backup seluruh lingkungan
  • Alert dikirim melalui multiple channel (email, SMS, ITSM)
  • Prosedur eskalasi jelas jika alert tidak ditindaklanjuti

Risiko Jika Tidak Terpenuhi:
Backup yang gagal tanpa terdeteksi berarti perusahaan tidak memiliki perlindungan saat dibutuhkan, tanpa menyadarinya.

8. Recovery Testing: Kapan Terakhir Restore Diuji?

Pertanyaan Kunci:

  • Kapan terakhir kali restore test dilakukan untuk setiap workload kritikal?
  • Apakah restore test mencakup seluruh aplikasi atau hanya file-level restore?
  • Apakah hasil restore test terdokumentasi dan ditinjau oleh pemilik bisnis?

Indikator Kesiapan:

  • Restore test dilakukan minimal setiap 3-6 bulan untuk workload kritikal
  • Hasil tes mencakup waktu recovery aktual vs target RTO
  • Dokumentasi recovery procedure diperbarui berdasarkan hasil tes

Risiko Jika Tidak Terpenuhi:
Backup yang belum pernah diuji restore-nya adalah risiko tersembunyi yang dapat menyebabkan kegagalan recovery saat insiden nyata.

9. RPO dan RTO: Apakah Target Sudah Didefinisikan dan Dapat Dipenuhi?

Pertanyaan Kunci:

  • Apakah RPO (Recovery Point Objective) dan RTO (Recovery Time Objective) telah didefinisikan untuk setiap workload?
  • Apakah target ini disepakati dengan pemilik bisnis atau hanya ditetapkan oleh IT?
  • Apakah hasil recovery test menunjukkan bahwa target RPO/RTO dapat dipenuhi?

Indikator Kesiapan:

  • RPO dan RTO terdokumentasi per workload dengan approval bisnis
  • Target realistis berdasarkan arsitektur backup dan recovery yang ada
  • Gap antara target dan kemampuan aktual teridentifikasi dan direncanakan perbaikannya

Risiko Jika Tidak Terpenuhi:
Tanpa RPO/RTO yang jelas, tim IT tidak memiliki panduan untuk memprioritaskan recovery, dan bisnis tidak memiliki ekspektasi yang realistis.

10. Documentation: Apakah Recovery Process Terdokumentasi?

Pertanyaan Kunci:

  • Apakah prosedur recovery terdokumentasi dengan langkah-langkah yang jelas?
  • Apakah dokumentasi mencakup contact person, dependency aplikasi, dan urutan recovery?
  • Apakah dokumentasi disimpan di lokasi yang dapat diakses saat produksi down (tidak hanya di sistem yang sedang direcovery)?

Indikator Kesiapan:

  • Runbook recovery tersedia untuk setiap workload kritikal
  • Dokumentasi diperbarui setelah setiap perubahan infrastruktur atau recovery test
  • Salinan dokumentasi disimpan offsite atau dalam format yang tidak bergantung pada sistem produksi

Risiko Jika Tidak Terpenuhi:
Saat insiden terjadi, tekanan waktu dan kepanikan dapat menyebabkan kesalahan fatal jika prosedur tidak terdokumentasi dengan baik.

Tabel Ringkasan Checklist Enterprise Backup Readiness

Untuk memudahkan evaluasi, berikut adalah ringkasan checklist dalam format tabel yang dapat digunakan sebagai self-assessment:

Area Evaluasi Pertanyaan Kunci Status (Ya/Tidak/Sebagian) Tindakan Perbaikan
Workload Coverage Semua workload kritikal terbackup?
Backup Frequency Frekuensi sesuai RPO bisnis?
Retention Retensi memenuhi compliance?
Backup Location Ada salinan offsite?
Immutability Ada backup immutable/air-gapped?
Access Control MFA dan least privilege diterapkan?
Monitoring Alert untuk failed job aktif?
Recovery Testing Restore test rutin dilakukan?
RPO & RTO Target terdefinisi dan realistis?
Documentation Recovery procedure terdokumentasi?

Gunakan tabel ini untuk mencatat status saat ini dan merencanakan tindakan perbaikan untuk setiap gap yang teridentifikasi.

Cara Menggunakan Checklist Ini

Checklist ini dirancang untuk menjadi titik awal evaluasi, bukan akhir dari proses. Berikut adalah langkah-langkah yang direkomendasikan:

Langkah 1: Kumpulkan Tim yang Tepat
Libatkan perwakilan dari tim infrastruktur, security, compliance, dan pemilik bisnis untuk workload kritikal. Perspektif yang beragam membantu mengidentifikasi gap yang mungkin terlewat.

Langkah 2: Lakukan Self-Assessment
Gunakan checklist di atas untuk menilai setiap area. Bersikaplah jujur: status “Tidak” atau “Sebagian” bukan kegagalan, melainkan peluang perbaikan.

Langkah 3: Prioritaskan Berdasarkan Risiko Bisnis
Tidak semua gap perlu diperbaiki sekaligus. Prioritaskan perbaikan berdasarkan dampak bisnis jika area tersebut gagal saat insiden.

Langkah 4: Buat Rencana Perbaikan
Untuk setiap gap yang teridentifikasi, definisikan tindakan perbaikan, owner, dan timeline. Integrasikan dengan roadmap IT yang lebih luas.

Langkah 5: Jadwalkan Review Berkala
Backup readiness bukan one-time assessment. Jadwalkan review berkala (misalnya setiap 6 bulan atau setelah perubahan infrastruktur besar) untuk memastikan kesiapan tetap terjaga.

Manfaat Free Backup Assessment dari Arupa

Bagi perusahaan yang ingin evaluasi lebih mendalam, Arupa menyediakan layanan Free Backup Assessment yang dapat membantu mengidentifikasi gap dengan lebih komprehensif. Assessment ini mencakup:

  • Risk Score: Penilaian tingkat risiko strategi backup saat ini
  • Gap Analysis: Identifikasi spesifik area yang memerlukan perbaikan
  • Recommendation: Rekomendasi tindakan prioritas berdasarkan best practice industri

Assessment ini tidak hanya memberikan laporan, tetapi juga diskusi dengan ahli Arupa untuk memahami konteks bisnis dan merancang roadmap perbaikan yang realistis.

Kesimpulan

Enterprise backup checklist ini bukan sekadar daftar periksa teknis, melainkan alat untuk memastikan bahwa strategi backup benar-benar siap mendukung kelangsungan bisnis saat insiden terjadi. Setiap area, dari workload coverage hingga dokumentasi recovery, memainkan peran kritis dalam menentukan apakah perusahaan dapat pulih dengan cepat atau mengalami downtime berkepanjangan.

Evaluasi kesiapan backup adalah investasi kecil yang dapat mencegah kerugian besar. Jika Anda ingin memahami seberapa siap strategi backup perusahaan Anda dan di mana peluang perbaikan terbesar, Arupa siap membantu dengan Download Enterprise Backup Checklist dan konsultasi lanjutan untuk merancang roadmap yang sesuai dengan kebutuhan bisnis Anda.

FAQ

Apa itu enterprise backup readiness?
Enterprise backup readiness adalah tingkat kesiapan strategi backup perusahaan untuk mendukung recovery saat insiden terjadi. Ini mencakup tidak hanya keberadaan backup, tetapi juga kemampuan restore, kepatuhan RPO/RTO, dan ketahanan terhadap ancaman seperti ransomware.

Mengapa recovery testing penting dalam checklist?
Recovery testing memverifikasi bahwa backup benar-benar dapat dipulihkan, bukan hanya tampak sukses di dashboard. Tanpa testing, perusahaan mungkin baru menyadari backup gagal saat benar-benar dibutuhkan.

Apa itu immutable backup dan mengapa perlu?
Immutable backup adalah salinan data yang tidak dapat diubah atau dihapus selama periode tertentu. Ini melindungi backup dari ransomware, insider threat, dan human error yang dapat menghapus jalur recovery.

Berapa sering sebaiknya restore test dilakukan?
Minimal setiap 3-6 bulan untuk workload kritikal, atau setelah perubahan infrastruktur besar. Frekuensi dapat disesuaikan berdasarkan risiko bisnis dan kebutuhan compliance.

Apa perbedaan RPO dan RTO?
RPO (Recovery Point Objective) adalah jumlah maksimum data loss yang dapat diterima, diukur dari waktu kegagalan ke backup terakhir. RTO (Recovery Time Objective) adalah waktu maksimum yang dapat ditoleransi untuk sistem down setelah gangguan.

Apakah checklist ini cocok untuk semua ukuran perusahaan?
Ya, prinsip dasarnya berlaku untuk SMB hingga enterprise besar. Skala implementasi dapat disesuaikan, tetapi area evaluasi seperti workload coverage, immutability, dan recovery testing relevan untuk semua ukuran.

Bagaimana jika banyak area yang statusnya “Tidak” atau “Sebagian”?
Itu wajar. Checklist ini dirancang untuk mengidentifikasi gap, bukan untuk membuat perusahaan tampak sempurna. Prioritaskan perbaikan berdasarkan risiko bisnis dan buat rencana bertahap.
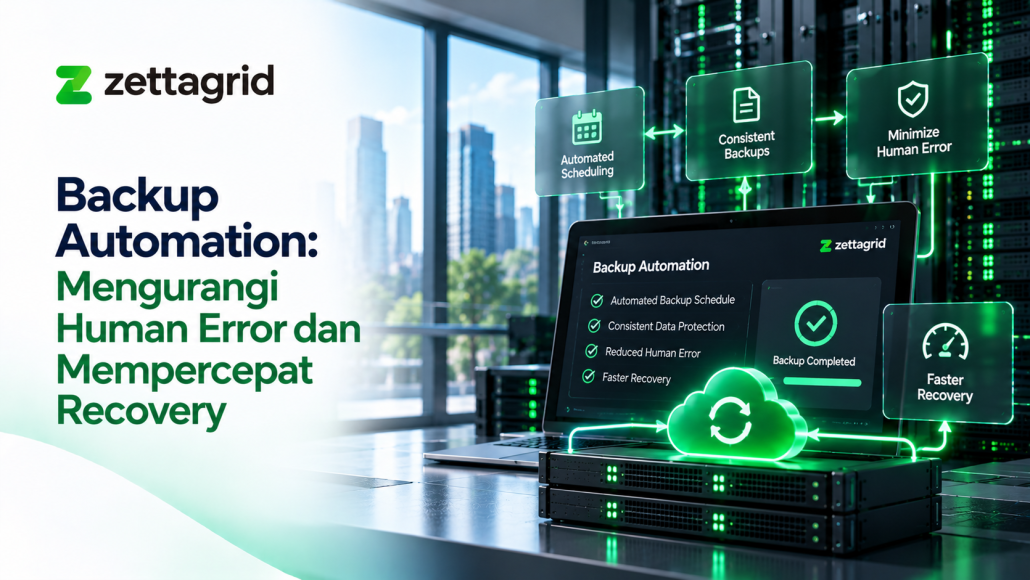
 

Backup Automation: Mengurangi Human Error dan Mempercepat Recovery

Ilustrasi Backup Automation untuk mengurangi human error dan mempercepat pemulihan data

Backup Automation membantu perusahaan mengurangi kesalahan manual dan meningkatkan efisiensi proses backup.

Dalam operasional backup enterprise, backup automation bukan lagi sekadar fitur tambahan, melainkan kebutuhan strategis. Human error tetap menjadi salah satu penyebab utama kegagalan backup dan recovery, mulai dari konfigurasi jadwal yang keliru, retention policy yang tidak konsisten, hingga job backup yang gagal tetapi tidak terdeteksi selama berminggu-minggu. Ketika disaster terjadi, proses recovery manual yang bergantung pada dokumentasi yang sudah kedaluwarsa atau tim yang sedang under pressure dapat memperpanjang downtime secara signifikan.

Artikel ini membahas bagaimana automated backup dapat mengurangi risiko human error, meningkatkan konsistensi operasional, dan mempercepat recovery time. Fokusnya bukan pada janji bahwa otomatisasi akan menghilangkan seluruh masalah, melainkan pada pemahaman realistis tentang apa yang dapat dan tidak dapat dicapai dengan automasi, serta bagaimana mengintegrasikannya ke dalam strategi data protection yang lebih luas.

Di Mana Human Error Paling Sering Terjadi dalam Backup?

Sebelum membahas solusi, penting untuk memahami di mana titik lemah operasional backup yang paling rentan terhadap kesalahan manusia. Berdasarkan pengalaman operasional di berbagai lingkungan enterprise, beberapa pola kesalahan muncul secara konsisten:

Konfigurasi Job Backup

Admin IT sering kali harus mengonfigurasi puluhan bahkan ratusan job backup untuk berbagai workload. Tanpa standarisasi, setiap job dapat memiliki pengaturan yang berbeda: jadwal, retensi, target repository, atau tingkat kompresi. Kesalahan kecil seperti salah memilih retention policy atau lupa mengaktifkan enkripsi dapat berakibat serius saat recovery diperlukan.

Manajemen Jadwal dan Retensi

Jadwal backup yang tidak terdokumentasi atau bergantung pada ingatan individu berisiko tinggi. Ketika admin yang bertanggung jawab cuti, resign, atau pindah tim, pengetahuan tentang “bagaimana backup berjalan” dapat hilang. Retention policy yang diterapkan secara manual juga rentan terhadap inkonsistensi: beberapa workload mungkin menyimpan backup terlalu lama (memboroskan storage), sementara yang lain terlalu singkat (tidak memenuhi kebutuhan compliance).

Missed Backup dan Failed Job yang Tidak Terperiksa

Backup job yang gagal tanpa notifikasi adalah risiko tersembunyi yang umum. Dashboard yang tidak dimonitor, alert yang dikirim ke email yang sudah tidak aktif, atau asumsi bahwa “backup pasti sukses” dapat menyebabkan perusahaan menyadari kegagalan backup hanya saat mencoba restore, yang mungkin sudah terlambat.

Kapasitas Storage yang Tidak Terpantau

Storage backup yang penuh adalah penyebab umum kegagalan backup mendadak. Tanpa monitoring proaktif, tim IT mungkin baru menyadari masalah ini setelah beberapa job gagal berturut-turut. Dalam skenario terburuk, backup tertunda selama berhari-hari sebelum kapasitas ditambah atau data lama dihapus.

Proses Recovery Manual

Saat disaster terjadi, tekanan waktu tinggi dan dokumentasi recovery yang tidak teruji dapat menyebabkan kesalahan fatal: restore ke target yang salah, urutan recovery yang tidak memperhatikan dependency aplikasi, atau lupa mengonfigurasi ulang network dan security setting. Human error dalam recovery sering kali lebih mahal dampaknya daripada error dalam backup rutin.

Bagaimana Backup Automation Membantu?

Automasi tidak menghilangkan seluruh risiko, tetapi secara signifikan mengurangi titik-titik kegagalan yang disebabkan oleh inkonsistensi manusia. Berikut adalah area di mana backup management berbasis automasi memberikan nilai paling besar:

  • Scheduling yang Konsisten dan Terprediksi

Dengan backup automation, jadwal backup didefinisikan dalam policy yang diterapkan secara terpusat. Setiap workload yang masuk dalam scope policy akan otomatis mendapat jadwal yang sama, mengurangi risiko lupa mengkonfigurasi backup untuk server baru atau workload yang baru di-deploy. Scheduling juga dapat disesuaikan dengan business hour, maintenance window, atau periode low-activity untuk meminimalkan dampak pada performa produksi.

  • Policy-Driven Retention

Retention policy yang didefinisikan secara terpusat memastikan konsistensi di semua workload. Misalnya, policy “daily backup retained 30 days, weekly retained 12 weeks, monthly retained 12 months” dapat diterapkan otomatis tanpa perlu konfigurasi manual per job. Ini juga membantu memenuhi kebutuhan compliance yang memerlukan retensi data jangka panjang.

  • Monitoring dan Alerting Proaktif

Sistem automasi modern menyediakan dashboard terpusat yang menampilkan status semua backup job, baik yang sukses, warning, maupun gagal. Alert dapat dikonfigurasi untuk mengirim notifikasi via email, SMS, atau integrasi dengan platform ITSM ketika job gagal, storage hampir penuh, atau ada anomali seperti backup yang tidak berjalan sesuai jadwal. Ini mengubah model operasional dari “reaktif setelah masalah ditemukan” menjadi “proaktif sebelum masalah berdampak”.

  • Automated Reporting dan Compliance

Laporan backup yang dihasilkan otomatis mengurangi beban administratif dan memberikan visibilitas yang konsisten untuk audit. Laporan dapat mencakup metrik seperti success rate, RPO actual vs target, kapasitas storage yang digunakan, dan tren kegagalan dari waktu ke waktu. Untuk industri yang diatur (finansial, kesehatan, sektor publik), laporan ini menjadi bukti kepatuhan terhadap kebijakan backup dan retention.

  • Verification dan Automated Restore Testing

Beberapa platform backup modern mendukung automated restore testing, di mana backup secara berkala diuji restore-nya ke environment isolated untuk memverifikasi integritas data. Hasil testing dilaporkan otomatis, memberikan keyakinan bahwa backup benar-benar dapat dipulihkan, bukan hanya tampak sukses di dashboard.

  • Orchestration Recovery Workflow

Untuk skenario disaster recovery yang kompleks, recovery automation dapat mengoordinasikan urutan restore berbagai komponen: database harus di-restore dulu sebelum aplikasi, network configuration harus diterapkan sebelum VM di-boot, dan seterusnya. Orchestration ini mengurangi risiko kesalahan urutan yang dapat menyebabkan aplikasi gagal start atau data tidak konsisten.

  • Batasan Automasi: Human Oversight Tetap Diperlukan

Meskipun automasi memberikan banyak manfaat, penting untuk memahami batasannya. Backup automation dapat mengurangi, tetapi tidak menghilangkan seluruh human error. Beberapa area yang tetap memerlukan keterlibatan manusia:

  • Desain Kebijakan dan Arsitektur

Automasi menjalankan apa yang didefinisikan dalam policy. Jika policy itu sendiri salah desain (misalnya, RPO terlalu longgar untuk workload kritikal, atau retention tidak memenuhi kebutuhan compliance), automasi hanya akan menjalankan kesalahan tersebut secara konsisten. Desain arsitektur backup, pemilihan RTO/RPO, dan penentuan workload priority tetap memerlukan judgement manusia.

  • Interpretasi Alert dan Eskalasi

Alert otomatis dapat memberitahu bahwa ada masalah, tetapi interpretasi dan eskalasi yang tepat tetap memerlukan analisis manusia. Misalnya, alert “backup gagal” dapat disebabkan oleh masalah jaringan temporer, bug software, atau kegagalan storage yang serius. Tim IT perlu menilai urgensi dan mengambil tindakan yang sesuai.

  • Perubahan Infrastruktur dan Workload Baru

Ketika infrastruktur berubah (server baru, migrasi cloud, perubahan network topology), policy backup perlu disesuaikan. Automasi tidak dapat mendeteksi perubahan ini secara otomatis tanpa integrasi yang mendalam dengan sistem inventory dan change management.

  • Recovery Decision yang Kompleks

Dalam skenario disaster besar, keputusan seperti “apakah kita failover ke site DR sekarang atau menunggu”, “workload mana yang diprioritaskan untuk di-restore dulu”, atau “apakah data yang terkorupsi dapat diterima” memerlukan judgement bisnis yang tidak dapat diotomatisasi sepenuhnya.

  • Security dan Access Control

Automasi tidak menggantikan kebutuhan akan kontrol akses yang ketat, audit trail, dan pemisahan duty (separation of duties). Siapa yang dapat mengubah policy backup, menghapus backup, atau initiate recovery tetap perlu dikontrol dan diaudit.

  • Best Practice Implementasi Backup Automation

Untuk memaksimalkan manfaat automasi sambil meminimalkan risiko, berikut beberapa best practice yang dapat diadopsi:

  • Mulai dari Policy, Bukan Tool

Sebelum mengimplementasikan automasi, definisikan terlebih dahulu kebijakan backup yang jelas: workload apa yang perlu dilindungi, RPO/RPO untuk masing-masing, retention requirement, dan lokasi backup (onsite, offsite, immutable). Policy ini kemudian diterjemahkan ke dalam konfigurasi tool automasi.

  • Terapkan Monitoring Berlapis

Jangan bergantung pada satu channel alert saja. Kombinasikan email notification, dashboard monitoring, dan integrasi dengan platform ITSM atau ticketing. Pastikan alert dikirim ke multiple recipient dan ada prosedur eskalasi yang jelas jika alert tidak ditindaklanjuti dalam waktu tertentu.

  • Dokumentasikan dan Uji Recovery Workflow

Otomatisasi recovery hanya berguna jika workflow-nya terdokumentasi dan teruji. Lakukan recovery drill secara berkala (minimal setiap 6 bulan) untuk memverifikasi bahwa automated runbook benar-benar berfungsi dan tim memahami peran mereka dalam proses recovery.

  • Integrasikan dengan Change Management

Ketika ada perubahan infrastruktur (server baru, aplikasi baru, migrasi), pastikan ada trigger otomatis atau checklist manual yang memperbarui policy backup. Integrasi antara sistem CMDB (Configuration Management Database) dan platform backup dapat membantu memastikan tidak ada workload yang terlewat.

  • Review dan Refine Policy Secara Berkala

Kebutuhan bisnis berubah, dan policy backup perlu menyesuaikan. Lakukan review berkala (misalnya setiap tahun atau setelah perubahan bisnis besar) untuk memastikan RPO/RTO masih relevan, retention masih sesuai compliance requirement, dan arsitektur backup masih optimal.

  • Jangan Abaikan Backup Manual untuk Kasus Khusus

Meskipun automasi mencakup sebagian besar workload, ada kasus di mana backup manual atau ad-hoc diperlukan (misalnya sebelum perubahan besar pada sistem kritikal). Pastikan ada prosedur yang jelas untuk backup semacam ini dan hasilnya tetap terdokumentasi dalam sistem monitoring.

Dampak pada RTO dan RPO

Salah satu manfaat paling konkret dari backup automation adalah kemampuannya untuk mendukung RPO yang lebih ketat dan RTO yang lebih cepat.

Untuk RPO, automasi memungkinkan frekuensi backup yang lebih tinggi tanpa beban operasional tambahan. Backup yang sebelumnya harian dapat ditingkatkan menjadi setiap beberapa jam atau bahkan continuous data protection untuk workload yang sangat kritikal. Karena jadwal dijalankan otomatis, risiko missed backup akibat human error berkurang secara signifikan.

Untuk RTO, automated recovery workflow dapat memangkas waktu yang diperlukan untuk restore. Prosedur yang sebelumnya memerlukan beberapa langkah manual (locate backup, mount repository, initiate restore, configure network, validate application) dapat dikompresi menjadi satu klik atau bahkan trigger otomatis. Untuk skenario disaster recovery, orchestration yang mengoordinasikan restore multiple komponen secara paralel dapat mengurangi downtime dari jam menjadi menit.

Namun, penting untuk diingat bahwa peningkatan RPO/RTO ini hanya tercapai jika arsitektur backup dan recovery dirancang dengan benar. Automasi mempercepat eksekusi, tetapi tidak mengubah batasan fisik seperti bandwidth jaringan atau kapasitas storage.

Integrasi dengan Managed Service dan Professional Service

Bagi banyak perusahaan, terutama yang memiliki tim IT terbatas, mengimplementasikan dan mengelola backup automation secara mandiri dapat menjadi tantangan. Di sinilah layanan managed backup dan professional service seperti yang ditawarkan Arupa dapat memberikan nilai tambah.

Arupa menyediakan layanan Assessment & Consultation yang membantu perusahaan mengevaluasi kesiapan backup saat ini, mengidentifikasi gap, dan merancang roadmap automasi yang sesuai dengan kebutuhan bisnis. Layanan ini mencakup review infrastruktur, analisis kebijakan backup existing, dan rekomendasi arsitektur yang optimal.

Selain itu, Arupa menawarkan managed service untuk implementasi, monitoring, dan pengelolaan backup secara end-to-end. Tim ahli Arupa dapat membantu mengonfigurasi automasi, setting monitoring dan alerting, serta melakukan recovery testing berkala. Ini memungkinkan tim IT internal fokus pada inisiatif strategis sambil memastikan bahwa backup operasional berjalan dengan andal.

Kesimpulan

Backup automation adalah investasi yang memberikan return jelas dalam bentuk pengurangan human error, peningkatan konsistensi operasional, dan percepatan recovery time. Namun, automasi bukan solusi ajaib yang menghilangkan seluruh risiko. Ia paling efektif ketika dipadukan dengan kebijakan yang terdefinisi dengan baik, monitoring proaktif, testing recovery rutin, dan oversight manusia yang tepat.

Bagi perusahaan yang masih bergantung pada proses backup manual atau semiotomatis, langkah pertama adalah mengevaluasi di mana titik-titik kerentanan human error paling besar, kemudian memprioritaskan automasi pada area tersebut. Tidak perlu mengotomatisasi semuanya sekaligus; pendekatan bertahap yang terukur sering kali lebih berkelanjutan.

Jika Anda ingin memahami seberapa siap strategi backup saat ini dan di mana automasi dapat memberikan dampak terbesar, Arupa menyediakan layanan Dapatkan Free Backup Assessment yang dapat membantu mengidentifikasi peluang perbaikan dan merancang roadmap implementasi yang sesuai dengan kebutuhan dan anggaran bisnis Anda.


FAQ

Apa itu backup automation?
Backup automation adalah penggunaan software dan policy terpusat untuk menjalankan jadwal backup, monitoring, alerting, dan reporting secara otomatis tanpa intervensi manual berulang. Tujuannya mengurangi human error dan meningkatkan konsistensi operasional backup.

Apakah automasi backup menghilangkan seluruh human error?
Tidak. Automasi mengurangi risiko kesalahan rutin seperti missed schedule atau konfigurasi inkonsisten, tetapi desain policy, interpretasi alert, dan keputusan recovery kompleks tetap memerlukan judgement manusia.

Bagaimana automasi membantu RPO dan RTO?
Automasi memungkinkan frekuensi backup lebih tinggi (mendukung RPO lebih ketat) dan recovery workflow yang terkoordinasi (mempercepat RTO). Namun, batasan fisik seperti bandwidth dan kapasitas storage tetap berlaku.

Apakah automated restore testing benar-benar diperlukan?
Ya. Backup yang belum pernah diuji restore-nya adalah risiko tersembunyi. Automated restore testing memverifikasi bahwa backup dapat dipulihkan dan memberikan laporan konsisten untuk audit.

Berapa sering sebaiknya saya review policy backup?
Minimal sekali setahun atau setelah perubahan bisnis besar (misalnya akuisisi, migrasi cloud, atau perubahan regulasi). Review memastikan RPO/RTO, retention, dan arsitektur backup masih relevan.

Apa peran managed service dalam backup automation?
Managed service membantu implementasi, monitoring, dan pengelolaan backup secara end-to-end. Ini berguna bagi perusahaan dengan tim IT terbatas atau yang ingin fokus pada inisiatif strategis.

Bagaimana memulai implementasi backup automation?
Mulailah dengan mendefinisikan kebijakan backup (RPO/RTO, retention, workload coverage), lalu pilih tool yang mendukung policy-driven automation, monitoring terpusat, dan alerting. Implementasi dapat dilakukan bertahap, dimulai dari workload paling kritikal.

Mengapa Enterprise Memilih Dedicated Private Cloud untuk Workload Mission-Critical?

Ilustrasi Dedicated Private Cloud untuk workload mission-critical enterprise

Dedicated Private Cloud membantu enterprise menjalankan workload mission-critical dengan keamanan, performa, dan availability yang lebih terkontrol.

Menjaga ketersediaan sistem inti tanpa kompromi adalah tantangan harian bagi tim IT di level enterprise. Ketika sebuah aplikasi perbankan, sistem ERP manufaktur, atau platform pemrosesan klaim asuransi mengalami gangguan beberapa menit saja, dampaknya bukan sekadar kerugian finansial langsung, melainkan rusaknya kepercayaan nasabah dan reputasi bisnis yang dibangun bertahun-tahun.

Dalam lanskap modernisasi infrastruktur saat ini, banyak organisasi beranggapan bahwa memindahkan seluruh beban kerja ke public cloud adalah satu-satunya jawaban. Namun, seiring berjalannya waktu, para CIO dan Head of IT mulai menyadari realitas di lapangan: tidak semua sistem diciptakan sama. Untuk workload mission-critical yang menangani transaksi bervolume tinggi, data sensitif, serta ketergantungan yang rumit, model multi-tenant pada public cloud sering kali menyisakan celah terkait konsistensi performa, prediktabilitas biaya, hingga isu kepatuhan regulasi.

Di sinilah enterprise private cloud mengambil peran strategis. Dengan mengisolasi sumber daya komputasi secara khusus untuk satu organisasi, pendekatan dedicated private cloud memberikan kombinasi yang ideal antara fleksibilitas layanan cloud modern dan tingkat kontrol serta keamanan layaknya infrastruktur on-premise.

Tantangan Enterprise dalam Menjalankan Workload Mission-Critical

Mengelola sistem yang memproses ribuan permintaan per detik membutuhkan fondasi yang kokoh. Dari hasil diskusi kami dengan berbagai praktisi IT di Indonesia, ada lima tantangan utama yang kerap muncul saat mengoperasikan workload skala besar:

  • Downtime yang Mempertaruhkan Bisnis: Kegagalan infrastruktur pada sistem utama bukan sekadar isu tiket IT biasa. Hal ini berpotensi menghentikan jalur produksi, menghambat transaksi nasabah, atau memicu denda keterlambatan kontrak.
  • Tingkat Keamanan dan Perlindungan Data: Ancaman siber yang kian canggih menuntut isolasi data yang ketat. Menggabungkan lingkungan data inti dengan tenant lain dalam shared environment sering kali menimbulkan kekhawatiran terkait noisy neighbors hingga potensi kebocoran data.
  • Tekanan Kepatuhan dan Regulasi: Sektor perbankan, keuangan, kesehatan, dan instansi pemerintah terikat oleh regulasi ketat terkait lokasi penyimpanan data (lokalisasi data), hak akses audit, serta mekanisme tata kelola data yang tidak bisa ditawar.
  • Kompleksitas Pengelolaan Server Tradisional: Di sisi lain, mempertahankan data center on-premise murni memerlukan alokasi sumber daya yang masif untuk pemeliharaan hardware, pembaruan firmware, hingga pengelolaan kapasitas fisik yang kaku.
  • Risiko Latensi dan Lonjakan Beban: Aplikasi bisnis tertentu membutuhkan latensi sangat rendah dan bandwidth yang stabil secara konsisten.

Sebagai contoh, sebuah perusahaan penyedia jasa keuangan yang memproses ribuan otorisasi pembayaran per detik tidak boleh mengalami fluktuasi latensi hanya karena pelanggan lain di server yang sama sedang menjalankan proses pemrosesan data secara masif (batch processing). Perusahaan tersebut membutuhkan kepastian sumber daya yang terisolasi total.

Studi Kasus: Ketika Perusahaan Membutuhkan Infrastruktur Cloud yang Lebih Terkontrol

Untuk memberikan gambaran yang nyata, mari kita tinjau skenario transformasi digital dari sebuah perusahaan penyedia jasa keuangan dan pembiayaan terkemuka.

Kondisi Awal

Perusahaan ini mengoperasikan sistem pemrosesan transaksi utama berbasis on-premise yang ditempatkan di data center milik sendiri. Seiring bertambahnya jumlah nasabah digital dan integrasi API dengan berbagai mitra fintech, beban pemrosesan harian melonjak hingga tiga kali lipat.

Infrastruktur fisik yang ada mulai mengalami keterbatasan kapasitas (capacity bottleneck). Proses penambahan server fisik (procurement hingga provisioning) membutuhkan waktu hingga beberapa bulan, yang akhirnya menghambat peluncuran fitur-fitur baru di aplikasi seluler mereka.

Tantangan Bisnis

Manajemen menetapkan beberapa persyaratan ketat yang harus dipenuhi oleh tim IT:

  1. High Availability 99.99%: Sistem otorisasi transaksi tidak boleh mati pada jam operasional bisnis.
  2. Kepatuhan Regulasi: Seluruh data nasabah dan log transaksi wajib berada di dalam wilayah hukum Indonesia dengan arsitektur yang siap diuji oleh auditor independen.
  3. Skalabilitas Cepat: Infrastruktur harus mampu menangani lonjakan transaksi pada periode tertentu (seperti tanggal gajian atau promo belanja) tanpa perlu membeli hardware baru yang tidak terpakai di hari biasa.
  4. Isolasi Lingkungan: Data keuangan tidak boleh berbagi sumber daya fisik dengan entitas bisnis lain demi alasan keamanan mutlak.

Solusi Dedicated Private Cloud

Melihat kebutuhan yang sangat spesifik ini, tim IT berkolaborasi untuk mengadopsi lingkungan managed private cloud. Melalui pendekatan ini, arsitektur yang dibangun meliputi:

  • Dedicated Hardware Infrastructure: Seluruh server fisik, penyimpanan (storage), dan perangkat jaringan dialokasikan secara penuh (single-tenant) untuk perusahaan tersebut.
  • Arsitektur Redundan: Penggunaan beberapa availability zone lokal untuk memastikan ketersediaan tinggi dan integrasi dengan solusi Disaster Recovery Zettagrid untuk jaminan kelangsungan bisnis.
  • Privatization & Control: Akses dan kontrol penuh terhadap hypervisor, pengaturan jaringan internal (VPC), serta kebebasan untuk mengimplementasikan kebijakan keamanan khusus.
  • Managed Services Support: Pengelolaan rutin seperti monitoring, patching, dan pemeliharaan infrastruktur ditangani oleh tim ahli eksternal, sehingga tim internal dapat fokus pada pengembangan aplikasi inti.

Hasil yang Dicapai

Transisi ke Private Cloud Zettagrid memberikan dampak nyata bagi operasional bisnis perusahaan:

  • Peningkatan Stabilitas: Sistem mampu menangani lonjakan beban transaksi tanpa ada penurunan performa (zero throttling).
  • Proses Deployment Lebih Cepat: Waktu penyediaan resource untuk tim pengembang berkurang dari hitungan minggu menjadi beberapa menit berkat fitur otomatisasi cloud.
  • Efisiensi Operasional: Beban tim IT internal dalam pemeliharaan hardware berkurang secara signifikan, memungkinkan mereka fokus pada inovasi produk finansial baru.
  • Audit Kepatuhan Lancar: Struktur infrastruktur yang terisolasi memudahkan perusahaan dalam memenuhi standar audit keamanan data dan regulasi keuangan nasional.

Mengapa Enterprise Memilih Dedicated Private Cloud?

Keputusan berpindah ke lingkungan private cloud dedicated bukanlah sekadar mengikuti tren teknologi, melainkan langkah rasional untuk melindungi aset digital paling berharga milik perusahaan.

+———————————————————————–+

| DEDICATED PRIVATE CLOUD ENVIRONMENT |

| |

| [ Enterprise Applications: ERP, Core Banking, Critical Databases ] |

| |

| +———————+ +———————+ +—————–+ |

| | Dedicated Compute | | Dedicated Storage | | Dedicated Net. | |

| +———————+ +———————+ +—————–+ |

| |

| +—————————————————————–+ |

| | Single-Tenant Physical Hardware (Isolated Infrastructure) | |

| +—————————————————————–+ |

+———————————————————————–+


1. Keamanan dan Kontrol Data Lebih Tinggi

Pada lingkungan dedicated private cloud, seluruh lapisan infrastruktur, mulai dari compute, storage, hingga networking, hanya digunakan oleh satu organisasi. Hal ini menghilangkan risiko keamanan terkait side-channel attacks atau masalah kebocoran data antartenant yang kadang menjadi perhatian pada public cloud. Perusahaan memegang kendali penuh atas kebijakan enkripsi, pengaturan firewall, hingga visibilitas log keamanan secara real-time.

2. Performa Stabil untuk Aplikasi Kritis

Beberapa jenis workload tidak toleran terhadap fluktuasi performa. Sistem seperti ERP enterprise, database relasional skala besar, dan aplikasi transaksi bisnis membutuhkan konsistensi I/O (Input/Output) serta latensi yang terprediksi. Dalam dedicated environment, Anda tidak perlu khawatir tentang fenomena noisy neighbors, yaitu kondisi di mana penggunaan resource oleh pengguna lain mengganggu kinerja sistem Anda.

3. Mendukung Compliance dan Regulasi

Bagi industri teregulasi di Indonesia, kepatuhan terhadap aturan tata kelola data adalah hal mutlak. Lingkungan private cloud enterprise memudahkan penetapan standar keamanan, lokasi fisik penyimpanan data yang jelas di dalam negeri, serta penerapan kontrol akses ketat yang dapat dibuktikan saat proses audit kepatuhan.

4. Skalabilitas Tanpa Kehilangan Fleksibilitas

Private cloud modern tidak lagi kaku seperti data center tradisional. Dengan integrasi platform manajemen terkini, Anda tetap mendapatkan keunggulan utama dari cloud computing, seperti self-service provisioning, auto-scaling, dan manajemen berbasis API. Anda mendapatkan fleksibilitas operasional tanpa harus mengorbankan kontrol atas Cloud Infrastructure Zettagrid.

Dedicated Private Cloud vs Public Cloud: Mana yang Tepat?

Untuk membantu menentukan strategi infrastruktur yang sesuai, tabel berikut merangkum perbandingan antara kedua pendekatan tersebut:

Faktor Public Cloud Dedicated Private Cloud
Resource Allocation Shared (Multi-tenant) Dedicated (Single-tenant)
Kontrol Akses & Arsitektur Terbatas pada konfigurasi standar Kontrol penuh hingga lapisan hypervisor
Security & Privacy Shared responsibility model Environment terisolasi secara fisik/logis
Customization Sesuai template penyedia Bebas disesuaikan dengan kebutuhan enterprise
Workload Kritikal Cocok untuk aplikasi non-sensitif/web umum Sangat cocok untuk core system & data sensitif
Prediktabilitas Biaya Biaya variatif sesuai konsumsi harian Biaya lebih terprediksi untuk pemakaian stabil

Pendekatan ini tidak berarti bahwa public cloud adalah pilihan yang buruk. Banyak enterprise modern yang mengadopsi model hybrid cloud, yaitu menggunakan public cloud untuk aplikasi depan yang membutuhkan jangkauan global, serta mempertahankan dedicated private cloud untuk menyimpan database inti dan sistem mission-critical.

Bagaimana Zettagrid Membantu Enterprise Mengadopsi Private Cloud?

Membuat transisi ke enterprise cloud solution memerlukan perencanaan matang agar tidak mengganggu operasional bisnis yang sedang berjalan. Zettagrid Indonesia hadir sebagai mitra strategis untuk mendampingi organisasi Anda di setiap tahapan modernisasi infrastruktur.

Melalui layanan Managed Services Zettagrid, kami mengedepankan pendekatan berbasis konsultasi. Tim spesialis cloud kami tidak sekadar menjual kapasitas server, melainkan memulai dengan melakukan asesmen mendalam terhadap arsitektur aplikasi, profil risiko, serta pola lalu lintas data di perusahaan Anda.

Langkah pendekatan kami meliputi:

  1. Infrastructure & Workload Assessment: Menganalisis ketergantungan antaraplikasi dan mengidentifikasi workload mana yang membutuhkan prioritas dedicated resources.
  2. Custom Cloud Design: Merancang arsitektur private cloud lokal yang aman, adaptif, dan siap mendukung ketersediaan tinggi.
  3. Seamless Migration: Menyusun dan mengeksekusi strategi migrasi dengan downtime minimal guna memastikan kelangsungan operasional melalui solusi Backup & Recovery Zettagrid.
  4. 24/7 Managed Operations: Memberikan dukungan pemantauan dan pengelolaan berkelanjutan agar tim IT Anda dapat berfokus penuh pada strategi bisnis inti.

Kesimpulan

Bagi perusahaan enterprise, pilihan infrastruktur bukan lagi sekadar mengikuti tren, melainkan keputusan strategis untuk menjaga kelangsungan bisnis. Dedicated private cloud menawarkan keseimbangan terbaik antara performa tinggi, kontrol keamanan penuh, kepatuhan regulasi, dan prediktabilitas biaya untuk workload mission-critical.

Dengan merancang lingkungan komputasi yang terisolasi dan terkelola dengan baik, perusahaan Anda dapat menjalankan aplikasi vital secara stabil tanpa mengorbankan fleksibilitas inovasi digital.

Konsultasikan kebutuhan backup dan recovery organisasi Anda bersama Zettagrid. Hubungi Zettagrid di marketing@zettagrid.id atau WhatsApp +62 811–9688–835 sekarang juga.


FAQ

Q: Apa itu enterprise private cloud?

A: Enterprise private cloud adalah lingkungan infrastruktur cloud computing yang dikhususkan secara eksklusif (single-tenant) untuk satu organisasi. Lingkungan ini menyediakan sumber daya komputasi, penyimpanan, dan jaringan yang terisolasi untuk menjamin keamanan, kontrol, dan performa tinggi.

Q: Mengapa perusahaan besar membutuhkan dedicated private cloud?

A: Perusahaan besar membutuhkan dedicated private cloud terutama untuk menjalankan workload mission-critical yang memerlukan konsistensi performa tinggi, isolasi data untuk keamanan ketat, serta kemudahan dalam memenuhi aturan kepatuhan regulasi industri.

Q: Apa perbedaan utama antara private cloud dan public cloud?

A: Perbedaan utamanya terletak pada penggunaan sumber daya. Public cloud menggunakan model shared infrastructure (beberapa pelanggan menggunakan server fisik yang sama), sedangkan private cloud memberikan infrastruktur yang terisolasi secara penuh untuk satu pelanggan saja.

Q: Apakah private cloud cocok untuk seluruh jenis workload kritikal?

A: Ya, private cloud sangat cocok untuk workload kritikal seperti sistem ERP, database transaksi keuangan, sistem data kesehatan, dan aplikasi inti enterprise yang membutuhkan latensi stabil, ketersediaan tinggi, dan perlindungan data tingkat tinggi.

Q: Bagaimana Zettagrid Indonesia membantu proses implementasi private cloud?

A: Zettagrid Indonesia menyediakan layanan secara end-to-end, mulai dari analisis kebutuhan (assessment), perancangan arsitektur kustom, proses migrasi data dengan downtime minimal, hingga pengelolaan dan pemantauan operasional 24/7 melalui layanan managed services.

Managed Disaster Recovery: Your Partner in Business Continuity

Managed Disaster Recovery Your Partner in Business Continuity

In the face of increasing threats like natural disasters, cyberattacks, and technical failures, businesses require reliable solutions to ensure continuity. Managed disaster recovery offers a specialized approach where third-party providers oversee the design, implementation, and management of disaster recovery strategies, enabling businesses to recover quickly and effectively.

This article explains the concept of managed disaster recovery, explores key components such as RPO and RTO, reviews various disaster recovery plans, and describes how managed disaster recovery operates to ensure uninterrupted business operations.

What is Disaster Recovery?

Disaster recovery refers to a set of strategies, processes, and technologies designed to restore systems, data, and IT infrastructure after significant disruptions such as natural disasters, cyberattacks, or technical failures. The main goal of disaster recovery is to ensure business continuity by minimizing downtime and potential losses.

Disaster recovery is a critical component of a disaster recovery plan (DRP), which involves risk identification, data backup management, and testing and training to prepare for disaster scenarios.

What is Managed Disaster Recovery?

Managed disaster recovery refers to outsourcing disaster recovery operations to a professional service provider. These services include planning, execution, testing, and ongoing support, ensuring your business can bounce back quickly after any disruption.

Unlike traditional in-house recovery methods, managed disaster recovery ensures round-the-clock expertise and advanced tools that might not be available internally. Providers often use cutting-edge technologies, such as cloud replication and automation, to ensure rapid recovery.

Key Benefits of Managed Disaster Recovery:

  • Expert Management: A team of professionals monitors and handles recovery processes.
  • Proactive Planning: Managed providers conduct risk assessments and create comprehensive recovery strategies tailored to your business.
  • Scalability: Solutions grow with your business, ensuring consistent protection.

RPO and RTO: Metrics That Define Managed Disaster Recovery

Two critical metrics in managed disaster recovery are Recovery Point Objective (RPO) and Recovery Time Objective (RTO). Managed services use these metrics to design plans that meet your business’s tolerance for downtime and data loss.

  1. RPO (Recovery Point Objective)
    RPO measures the maximum acceptable amount of data loss during a disruption. Managed disaster recovery providers set automated, frequent backups or continuous data replication to achieve low RPOs.
    • Example: A business with a 2-hour RPO requires backups every 2 hours to ensure minimal data loss. Managed recovery solutions optimize this process using real-time replication.
  2. RTO (Recovery Time Objective)
    RTO refers to the maximum time a business can tolerate for systems to be restored. Managed disaster recovery services use advanced failover mechanisms to meet strict RTOs.
    • Example: If your RTO is 30 minutes, a managed solution might rely on cloud failover systems to ensure your operations resume within half an hour.

By aligning RPO and RTO with business needs, managed disaster recovery guarantees faster recovery and minimal impact on operations.

Types of Disaster Recovery Plans Managed Providers Implement

Managed disaster recovery providers specialize in designing and implementing various types of recovery plans, ensuring tailored solutions for different business needs:

  1. Cloud-Based Disaster Recovery
    Data and systems are replicated to the cloud, allowing businesses to restore operations virtually. Managed providers handle data synchronization, making this option cost-effective and scalable.
  2. Data Center Disaster Recovery
    On-premises systems are backed up at secondary data centers. Managed services ensure smooth transition and recovery by maintaining redundant infrastructure offsite.
  3. Hybrid Disaster Recovery
    Combines cloud-based and on-premises solutions for greater flexibility. Managed providers oversee this complex setup to maximize reliability.
  4. Disaster Recovery as a Service (DRaaS)
    A fully managed service where the provider handles everything from replication to failover and testing. Zerto DRaaS is the most comprehensive option, ensuring businesses are always prepared.

How Managed Disaster Recovery Works

Here’s how managed disaster recovery providers ensure rapid recovery with minimal downtime:

  1. Assessment and Planning
    Providers evaluate your systems, identify risks, and develop a tailored recovery strategy. This includes defining RPOs and RTOs that align with your business requirements.
  2. Data Backup and Replication
    Using advanced tools, providers automate backups and implement real-time data replication. These ensure your data is always up to date, even in the event of a disaster.
  3. Failover Systems
    Managed solutions include automated failover systems, where operations switch to backup servers (cloud or on-premises) instantly during disruptions.
  4. Testing and Monitoring
    Regular testing ensures recovery plans remain effective. Providers monitor systems 24/7 to detect and resolve potential issues proactively.
  5. Recovery and Restoration
    When a disaster occurs, the provider initiates the recovery process, restoring systems and data to their pre-disaster state while ensuring continuity with minimal interruption.

Why Choose Zerto for Managed Disaster Recovery?

When it comes to managed disaster recovery, Zerto stands out as a leader in delivering innovative, reliable, and efficient solutions. With Zerto, your business gains access to advanced tools and expert services that ensure seamless recovery, minimal downtime, and optimal performance.

Why Zerto?

  • Continuous Data Protection: Achieve near-zero RPOs with Zerto’s real-time replication technology.
  • Fast Recovery: Meet strict RTOs with Zerto’s automated recovery workflows.
  • Cloud Agility: Integrate seamlessly with leading cloud platforms for maximum flexibility.
  • Simplified Management: Zerto’s intuitive interface makes disaster recovery easy to monitor and control.
  • Proven Expertise: Trusted by thousands of organizations worldwide, Zerto ensures your business is in capable hands.

Don’t let disasters disrupt your business. Partner with Zettagrid Indonesia to implement a managed Zerto disaster recovery solution tailored to your needs. Ensure your operations stay resilient, no matter what challenges arise.

Ready to get started?
Contact Zettagrid Indonesia to schedule a free consultation and explore how our managed disaster recovery solutions can protect your business.

Be proactive. Be prepared. Be resilient—with Zerto.

Apa Itu RTO dan RPO dan Manfaatnya dalam Business Continuity dan Disaster Recovery

Dalam dunia teknologi informasi, terutama di bidang manajemen keamanan data dan pemulihan bencana (disaster recovery), terdapat dua konsep penting yang sering kali menjadi pusat perhatian: Recovery Time Objective (RTO) dan Recovery Point Objective (RPO). Kedua konsep ini memainkan peran kunci dalam memastikan kelangsungan bisnis dan integritas data di dunia digital yang penuh risiko. Artikel ini akan membahas secara mendalam RTO dan RPO, dari yang umum hingga yang spesifik, serta mengapa kedua konsep ini sangat penting dalam lingkungan bisnis saat ini. 

Dalam era digital saat ini, data menjadi salah satu aset paling berharga bagi perusahaan. Data tidak hanya berisi informasi pelanggan dan transaksi, tetapi juga termasuk kode sumber aplikasi, konfigurasi jaringan, dan berbagai jenis informasi yang penting untuk operasi sehari-hari perusahaan. Oleh karena itu, keamanan data dan kemampuan pemulihan data (data recovery) yang efektif sangatlah penting. 

RTO dan RPO adalah dua konsep kunci dalam merancang strategi disaster recovery dan manajemen risiko data. Masing-masing konsep memiliki peran dan arti yang berbeda dalam konteks perlindungan data dan pemulihan setelah bencana atau kejadian tak terduga lainnya. Mari kita mulai dengan pemahaman yang lebih umum tentang keduanya. 

RTO (Recovery Time Objective) – Batasan Waktu Pemulihan 

RTO, atau Recovery Time Objective, adalah waktu maksimal yang diberikan kepada sebuah sistem atau aplikasi untuk pulih setelah terjadi bencana atau gangguan. Dalam kata lain, RTO mengukur berapa lama perusahaan dapat mengizinkan sistem atau aplikasi tidak beroperasi sebelum terjadi dampak yang tidak dapat diterima. RTO umumnya diukur dalam satuan waktu seperti jam, menit, atau bahkan detik, tergantung pada kebutuhan bisnis. 

Misalnya, jika sebuah perusahaan memiliki RTO 4 jam untuk sistem manajemen inventaris mereka, ini berarti bahwa sistem tersebut harus kembali beroperasi dalam waktu empat jam setelah terjadi gangguan atau bencana. Jika pemulihan sistem memakan waktu lebih dari empat jam, maka perusahaan tersebut dapat mengalami dampak negatif yang signifikan, seperti kehilangan penjualan atau ketidakpuasan pelanggan. 

Pentingnya RTO adalah memastikan bahwa perusahaan memiliki disaster recovery plan yang efektif dan dapat diandalkan. RTO membantu perusahaan menetapkan prioritas dalam data recovery dan sistem, serta menentukan sumber daya yang diperlukan untuk mencapai target waktu pemulihan tersebut. 

RPO (Recovery Point Objective) – Batasan Titik Pemulihan 

Selanjutnya, kita akan membahas Recovery Point Objective atau RPO. RPO adalah konsep yang berfokus pada sejauh mana perusahaan dapat menerima kehilangan data dalam kejadian bencana atau gangguan. RPO diukur dalam periode waktu yang sama seperti RTO, yaitu jam, menit, atau detik, tergantung pada kebutuhan bisnis. 

Misalnya, jika sebuah perusahaan memiliki RPO 1 jam untuk sistem basis data pelanggan mereka, ini berarti bahwa perusahaan dapat menerima kehilangan data hingga satu jam sebelum bencana atau gangguan terjadi. Dalam konteks ini, “kehilangan data” bisa berarti bahwa semua perubahan atau transaksi yang terjadi dalam satu jam terakhir sebelum gangguan mungkin tidak dapat dipulihkan. 

RPO sangat penting karena mengukur sejauh mana perusahaan dapat membatasi kerugian data dalam skenario yang tidak diinginkan. RPO yang lebih rendah mengharuskan perusahaan untuk melakukan cadangan data lebih sering, yang dapat menjadi tugas yang lebih sulit dan mahal. Namun, ini juga berarti bahwa perusahaan dapat memulihkan data yang lebih baru dan memiliki tingkat kehilangan data yang lebih rendah. 

Mengapa RTO dan RPO Penting? 

Sekarang, kita telah memahami apa itu RTO dan RPO secara umum. Namun, mengapa kedua konsep ini sangat penting dalam dunia bisnis dan teknologi informasi? 

Kelangsungan Bisnis 

Salah satu alasan utama adalah kelangsungan bisnis. Setiap perusahaan ingin memastikan bahwa operasinya dapat terus berjalan meskipun mengalami gangguan atau bencana. RTO memastikan bahwa waktu pemulihan sistem atau aplikasi tidak melebihi batasan yang dapat diterima oleh bisnis, sehingga bisnis dapat kembali beroperasi sesegera mungkin. 

Sementara itu, RPO memastikan bahwa data yang hilang selama bencana atau gangguan dapat dipulihkan dalam batasan yang dapat diterima. Ini penting terutama untuk bisnis yang bergantung pada data pelanggan, informasi keuangan, atau data penting lainnya. Dengan memiliki RPO yang baik, perusahaan dapat meminimalkan kerugian data dan menghindari dampak yang merugikan. 

Kepuasan Pelanggan 

Kepuasan pelanggan adalah faktor lain yang sangat dipengaruhi oleh RTO dan RPO. Jika sebuah perusahaan tidak dapat memulihkan layanan atau data dengan cepat setelah terjadi gangguan, pelanggan mungkin akan kecewa dan beralih ke pesaing. RTO yang lambat dapat menyebabkan penurunan kepuasan pelanggan dan potensi kehilangan bisnis. 

Kepatuhan Regulasi 

Banyak industri dan negara memiliki regulasi yang mengharuskan perusahaan untuk melindungi data pelanggan dan bisnis. Misalnya, General Data Protection Regulation (GDPR) di Uni Eropa mengharuskan perusahaan untuk melindungi data pelanggan dan memberikan kemampuan data recovery yang baik. RTO dan RPO yang baik dapat membantu perusahaan mematuhi regulasi tersebut dan menghindari denda dan sanksi yang mungkin diberikan. 

RTO dan RPO dalam Praktik 

Setiap perusahaan memiliki kebutuhan yang berbeda-beda ketika mengatur RTO dan RPO mereka. Beberapa faktor yang mempengaruhi penentuan RTO dan RPO meliputi: 

Jenis Data 

Jenis data yang diolah oleh perusahaan dapat memengaruhi RTO dan RPO. Data yang sangat penting, seperti data pelanggan atau data keuangan, mungkin memiliki RTO dan RPO yang lebih ketat daripada data yang kurang penting. 

Sumber Daya 

Ketersediaan sumber daya juga merupakan faktor yang memengaruhi RTO dan RPO. Perusahaan dengan anggaran yang lebih besar mungkin dapat mengatur RTO dan RPO yang lebih ketat karena mereka memiliki akses ke teknologi disaster recovery yang lebih canggih. 

Risiko Industri 

Industri tempat perusahaan beroperasi juga dapat memengaruhi penentuan RTO dan RPO. Industri yang lebih rentan terhadap bencana atau serangan mungkin memerlukan RTO dan RPO yang lebih ketat. 

Kebijakan Internal 

Kebijakan internal perusahaan juga berperan dalam penentuan RTO dan RPO. Perusahaan harus mempertimbangkan berapa banyak risiko yang bersedia mereka ambil dan berapa banyak sumber daya yang mereka siapkan untuk disaster recovery. 

Implementasi RTO dan RPO 

Setelah perusahaan menentukan RTO dan RPO mereka, langkah berikutnya adalah mengimplementasikan strategi pemulihan yang sesuai. Beberapa langkah yang dapat diambil untuk mencapai RTO dan RPO yang ditetapkan adalah: 

Cadangan Data Reguler 

Mengamankan data secara teratur adalah langkah penting untuk mencapai RPO yang rendah. Perusahaan harus membuat cadangan data dengan frekuensi yang memadai sesuai dengan RPO mereka. Ini dapat dilakukan dengan bantuan perangkat lunak cadangan data dan sistem penyimpanan yang andal. 

Redundansi Infrastruktur 

Menggunakan infrastruktur yang redundan dapat membantu mencapai RTO yang lebih cepat. Ini berarti bahwa perusahaan memiliki salinan sistem dan aplikasi yang siap digunakan jika sistem utama mengalami gangguan. 

Pengujian Pemulihan 

Menguji disaster recovery plan secara teratur adalah langkah penting untuk memastikan bahwa RTO dan RPO yang ditetapkan dapat dicapai. Pengujian pemulihan memberikan kesempatan untuk mengidentifikasi potensi masalah dan perbaikannya sebelum terjadi kejadian yang sebenarnya. 

Pemantauan Berkelanjutan 

Mengawasi sistem dan aplikasi secara terus-menerus dapat membantu mendeteksi gangguan atau bencana lebih cepat, yang pada gilirannya dapat membantu mencapai RTO yang lebih singkat. 

Studi Kasus: Peran RTO dan RPO dalam Bisnis E-Commerce 

Untuk memberikan contoh konkret tentang bagaimana RTO dan RPO berperan dalam dunia bisnis, mari kita lihat studi kasus dalam konteks bisnis e-commerce. 

RTO dalam Bisnis E-Commerce 

Dalam bisnis e-commerce, RTO dapat menjadi perbedaan antara mempertahankan pelanggan atau kehilangan mereka. Misalnya, pertimbangkan toko online yang menjual produk-produk fashion. Jika sistem toko online tersebut mengalami gangguan dan pelanggan tidak dapat melakukan pembelian selama berjam-jam, pelanggan mungkin akan beralih ke pesaing yang lebih dapat diandalkan. Oleh karena itu, RTO yang cepat sangat penting dalam hal ini. 

RPO dalam Bisnis E-Commerce 

Sementara itu, RPO dalam bisnis e-commerce mengacu pada sejauh mana data pesanan dan inventaris dapat dipulihkan setelah terjadi gangguan. Jika toko online kehilangan data pesanan selama satu jam sebelum terjadi gangguan, ini dapat mengakibatkan kebingungan yang besar dan hilangnya pendapatan. Oleh karena itu, RPO yang ketat, mungkin hanya beberapa menit, sangat penting untuk memastikan integritas data pesanan dan inventaris. 

Dengan menetapkan RTO dan RPO yang sesuai, bisnis e-commerce dapat memastikan bahwa mereka dapat menjaga kelangsungan bisnis, memuaskan pelanggan, dan melindungi data dengan baik. 

Kesimpulan 

RTO dan RPO adalah dua konsep yang sangat penting dalam dunia manajemen keamanan data dan disaster recovery. Kedua konsep ini membantu perusahaan mengatur batasan waktu pemulihan dan batasan titik pemulihan untuk sistem dan data mereka. Dengan memahami RTO dan RPO, perusahaan dapat merancang strategi pemulihan yang efektif, melindungi bisnis mereka, dan memuaskan pelanggan. 

Penting untuk diingat bahwa setiap perusahaan memiliki kebutuhan yang berbeda-beda, dan oleh karena itu, RTO dan RPO harus disesuaikan dengan kebutuhan bisnis. Selain itu, implementasi dan pengujian rencana pemulihan juga penting untuk memastikan bahwa RTO dan RPO yang ditetapkan dapat dicapai dalam situasi nyata. 

Dalam dunia yang terus berubah dan penuh risiko ini, pemahaman tentang RTO dan RPO adalah langkah penting menuju keberhasilan dan kelangsungan bisnis yang berkelanjutan. Semoga artikel ini telah membantu Anda memahami konsep ini dengan lebih baik dan bagaimana mereka dapat diterapkan dalam lingkungan bisnis Anda. 

Zettagrid Indonesia menyediakan solusi lengkap untuk keberlanjutan bisnis dan disaster recovery yang mencakup pemulihan data, toleransi kesalahan, dan ketersediaan tinggi. Kami membuat pemulihan bencana menjadi lebih mudah dan terjangkau dengan menawarkan berbagai solusi disaster recovery yang sesuai dengan kebutuhan bisnis Anda. Hubungi kami di sales@zettagrid.id untuk informasi lebih lanjut. 

StarHub and Zettagrid sign Cloud Teaming Agreement

We are pleased to announce that StarHub and Zettagrid has signed a teaming agreement for the deployment of Cloud solutions for StarHub business customers in Singapore. The Zettagrid service provides StarHub with a comprehensive range of on-demand cloud services including Veeam backup, disaster recovery and VMware private and hybrid cloud environments.

Starhub customers will be able to now combine robust and resilient StarHub network with flexible and scalable cloud services, all bundled together.
“We are excited that through our partnership with Zettagrid, the benefits of the backup and cloud services will be made available to our corporate customers, including fixed price billing for cloud services which will give CFOs certainty of their IT budgets whilst giving them flexibility to scale when they need to,” says StarHub Head, ICT Solution Sales Lawrence Koh.

“We’re all about reducing complexity for our customers in Singapore,” said Nathan Harman, Managing Director of Zettagrid. “With our award-winning, scalable, automated infrastructure services adding real value, Starhub can take advantage of cloud simplicity to benefit their customers”.

FOR MORE INFORMATION
For enquiries or to schedule an interview, please contact:

Starhub – Lawrence Koh, (e) lawrencekoh@starhub.com , (d) +65 6825 525

Zettagrid (Singapore) – Raymond Jeffrey, (e) raymond.jeffrey@zettagrid.com , (m) +65 9633 7994

Zettagrid (Australia) – Nicholas Power, (e) nicholas.power@zettagrid.com , (d) +61 8 9488 9536

About Zettagrid
www.zettagrid.com
Zettagrid delivers Private and Hybrid Cloud Hosting, Backup, Disaster Recovery, Software Licensing to IT Providers in 8 availability zones across the Asia Pacific region. We offer an easy to use, super scalable and highly available Cloud services which are self-service and fully automated.

About Starhub
www.starhub.com
StarHub is a leading homegrown Singapore company that delivers world-class communications, entertainment and digital services. With our extensive fibre and wireless infrastructure and global partnerships, we bring to people, homes and enterprises quality mobile and fixed services, a broad suite of premium content, and a diverse range of communication solutions. We develop and deliver to corporate and government clients solutions incorporating artificial intelligence, cybersecurity, data analytics, Internet of Things and robotics. We are committed to conducting our business in a sustainable and environmentally responsible manner. Listed on the Singapore Exchange mainboard, StarHub is a component stock of the SGX iEdge SG ESG Leaders and Transparency Indices and included in ESG-focused FTSE4Good Index Series. StarHub is ranked as the world’s most sustainable Wireless Telecommunications Service Provider and Singapore’s most sustainable Telco, in Corporate Knights Global 100.

Disaster Recovery using Veeam Solutions

Disaster Recovery using Veeam Solutions

Maintaining the availability of a business is one of the critical factors that most companies should pay attention. If the business process suddenly stopped, even just for a few seconds, we can’t imagine how many data transactions will be impacted.

To prevent this from happening, we need to maximize the availability of our business, one of which is by implementing a Disaster Recovery solution.

What is a Disaster Recovery? How does Disaster Recovery work? What kind of Disaster Recovery solution that’s suitable for my business? Check out the full explanation in the webinar “Disaster Recovery using Veeam Solutions“, which will feature Teddi Suryadi, as a Cloud Consultant in Zettagrid Indonesia.

Event Details:

Day: Wednesday, 15 June 2022

Time: 2.00–4.00 PM

Link to register:

LIVE from Zoom.

Reserve your slot and get a chance to win FREE Shopping Vouchers, special promos, and get an e-certificate.

Mitigating The Risk of Hacker And Ransomware with Backup

hacker and ransomwareMitigating The Risk of Hacker And Ransomware with Backup

As digital technology evolves today, ransomware becomes one of easily concerning cyber scourge of our time. This type of malware can infect your computers, locking down business data and systems, until you have no access to it all. Most companies will usually pay the ransom as any downtime at all could be devastating to their business continuity. However, it doesn’t guarantee that your business data will be corrupt-free or has no malware infectious that caused data loss. Then, what can enterprises take to protect their data and business continuity against ransomware?

Find the answer on “Zettagrid #NgabuburIT: Mitigating The Risk of Hacker And Ransomware with Backup” and meet our expert, Gery Surjaudaja as Product Specialist at Zettagrid Indonesia.

Event Details:

Date: Thursday, 21 April 2022

Time: 03.00 – 04.00 PM

Link to register: bit.ly/zgngabuburit

Join us and win OVO credits! Limited slots!

Mengapa Bisnis Anda Membutuhkan Disaster Recovery?

Mengapa DIsaster Recovery

Mengapa Bisnis Anda Membutuhkan DIsaster Recovery

Bisnis digital di Indonesia semakin terasa perkembangannya. Salah satu buktinya adalah posisi Indonesia sebagai negara 10 besar dengan pertumbuhan nilai perdagangan e-commerce. Hal ini diungkapkan langsung oleh Direktur Pemberdayaan Informatika, Direktorat Jenderal Aplikasi Informatika Kementerian Kominfo, Septriana Tangkary. Beliau mengatakan jika Indonesia berada di peringkat nomor 1 dunia dengan angka pertumbuhan nilai dagang 78%.

Dengan pertumbuhan yang positif ini, tentunya dibutuhkan solusi-solusi IT yang mumpuni untuk mendukung sistem IT bisnis yang reliable. Salah satunya adalah dengan penggunaan solusi Disaster Recovery. Dengan menggunakan Disaster Recovery, bisnis anda dapat terhindar dari kejadian-kejadian yang tidak terduga seperti bencana alam dan kebakaran, selain itu anda juga dapat menghindari downtime yang berkepanjangan. Mau tau lebih lanjut mengapa bisnis anda membutuhkan solusi ini? Yuk simak bahasan berikut ini:


  • Menghindari dari bencana yang tak terduga

Pernahkan anda mendengar berita mengenai gedung data center yang terbakar beberapa waktu lalu? Bayangkan jika hal itu terjadi pada bisnis anda dan pada saat itu anda sedang melakukan sistem development ataupun kegiatan penting lainnya. Jika anda belum memiliki solusi Disaster Recovery, anda tidak dapat terhindar dari server yang mati beberapa hari. Apalagi jika penyebabnya adalah kebakaran yang pastinya akan membutuhkan waktu yang cukup lama untuk mengembalikan bisnis anda kembali normal. Dengan Disaster Recovery, hal ini dapat di minimalisir, karena server anda akan tetap berjalan di cloud (off-site).

  • Mencegah terjadinya kehilangan data serta meminimalisir terjadinya downtime

Human error atau kesalahan manusia juga termasuk alasan mengapa anda membutuhkan Disaster Recovery. Misalnya anda sedang membangun suatu sistem di website atau aplikasi anda lalu tiba-tiba tim anda melakukan kesalahan sehingga data yang sudah tersimpan menjadi terhapus. Tidak hanya hilang, ternyata hal ini juga menyebabkan sistem pada server anda down sehingga pelanggan anda tidak dapat mengakses aplikasi anda. Dengan solusi Disaster Recovery, data anda tentunya masih dapat terselamatkan dan sistem masih dapat berjalan karena anda mempunyai salinannya di cloud.

  • Menghindari anda dari kehilangan pelanggan

Pernahkah anda mengalami downtime disaat anda mengadakan diskon besar-besaran di bisnis anda? Bayangkan jika pada saat itu anda sedang mengadakan launching produk disaat hari belanja online nasional dan website maupun aplikasi anda mengalami downtime karena banyaknya traffic yang masuk ke server anda. Hal ini dapat menyebabkan hilangnya kepercayaan pelanggan anda terhadap bisnis anda. Belum lagi biaya yang sudah anda keluarkan untuk promosi campaign tersebut menjadi terbuang sia-sia karena sistem anda yang tidak dapat diakses. Namun anda tidak perlu khawatir, hal ini dapat dihindari dengan menggunakan Disaster Recovery.

Zettagrid sebagai penyedia layanan cloud di Indonesia memiliki berbagai solusi Disaster Recovery (DR) yang anda dapat gunakan pada bisnis anda. Anda tidak perlu ragu jika bisnis anda mengharuskan anda untuk menaruh data di Indonesia, karena Zettagrid sendiri memiliki 2 lokasi data center di Indonesia dengan SLA 99.9% yang dapat menjamin anda dari terjadinya downtime. Selain itu tim support kami juga siap membantu anda 24/7 melalui website, email, telpon dan bahkan whatsapp kapanpun dan dimanapun anda berada. Belum lagi saat ini kami sedang mengadakan penawaran spesial diskon sebesar 25% untuk layanan SecondSite DR. Jika anda tertarik anda dapat menghubungi kami disini atau email kebutuhan anda di marketing@zettagrid.id.

5 Faktor Kesuksesan Startup

kesuksesan startup5 Faktor Kesuksesan Startup

Fenomena Startup bukan lagi menjadi hal asing yang kita temui di masa kini. Menjamurnya model bisnis satu ini kerap kali menjadi pilihan bagi setiap orang untuk juga merintis usaha, hingga menjadi pembahasan hangat yang tiada habisnya kita temui di berbagai media. Di Indonesia sendiri, startup mengalami perkembangan yang pesat dan mehasilkan valuasi hingga mencapai Rp 14 Triliun. Dengan besarnya nilai dan kesuksesan tersebut, startup Indonesia pun berkontribusi terhadap pertumbuhan ekonomi nasional seperti Pendapatan Domestik Bruto (PDB) Nasional.

Meski beberapa diantaranya mengalami kesuksesan, tak sedikit pula startup yang mengalami kegagalan. Hal ini karena persaingan ide, inovasi, dan manajemen anggaran menjadi hal yang menantang untuk dikelola dan dikembangkan. Itulah mengapa, dalam membangun startup, berbagai strategi pun perlu dilakukan oleh para pelaku usaha. Sehingga, nantinya kesuksesan startup pun akan tercapai sesuai rencana.

Lalu, bagaimana para pelaku usaha mencapai hal tersebut?

Di artikel kali ini, akan dibahas mengenai faktor yang dapat menjadi kesuksesan bagi sebuah startup. Penasaran seperti apa? Simak dulu beberapa di antaranya berikut ini:

1. Eksekusi ide bisnis yang matang

kesuksesan startup

(Source: ngocphuq1404 from pixabay)

Dalam membangun startup, tentu dibutuhkan ide yang inovatif untuk mencapai sebuah kesuksesan. Bila ide startup Anda bisa menjadi jawaban atas permasalahan yang selalu dihadapi oleh konsumen, itu bisa menjadi salah satu factor pendukungnya.

Akan tetapi, memiliki ide saja tidak akan cukup untuk membuat startup Anda sukses. Eksekusi yang matang juga perlu dilakukan oleh pelaku usaha, mengingat 98% keberhasilan startup ditentukan oleh hal tersebut.

Memiliki tim yang berpengalaman bisa menjadi salah satu cara untuk mengeksekusi ide inovatif bisnis Anda. Dengan latar belakang dan kemampuan kerja sama tim yang baik, akan membantu pengambilan keputusan yang optimal untuk kebutuhan ekskusi ide inovatif. Sehingga, kesuksesan startup pun dapat terukur karena hal tersebut.

2. Kecepatan startup dalam menyelesaikan masalah

kesuksesan startup

(Source: Deagreez from Getty Images Pro)

Startup yang sukses tidak pernah menunda proses untuk menyelesaikan sesuatu dan harus bekerja sebanyak yang dibutuhkan untuk menyelesaikan segala sesuatunya. Itulah mengapa, menyelesaikan sesuatu dengan cepat merupakan salah satu dari banyak alasan mengapa startup bisa mencapai kesuksesan. Sehingga, ini akan menunjukan perbedaan startup tersebut dengan startup lainnya ketika berbicara tentang kecepatan untuk mengelola risiko dan tantangan bisnis.

3. Manajemen waktu yang baik

kesuksesan startup

(Source: Canva Studio from Pexels)

Dalam merintis sebuah bisnis, banyak hal perlu dikerjakan oleh pelaku usaha agar startup dapat terus berkembang. Bahkan, banyaknya tugas tersebut terkadang membuat pekerjaan startup terasa berat dan panjang, mengingat sumber daya dan timnya yang masih terbatas.

Untuk membantu bisnis mengatasi hal ini, membangun produktivitas dan efektivitas tim bisa menjadi salah satu caranya. Dengan mengutamakan hal-hal yang bersifat prioritas dan mengesampingkan hal-hal yang sepele oleh tim, ini akan membantu startup untuk menghadapi tantangan dan mencapai kesuksesan.

4. Alokasi anggaran yang efektif

(Source: bongkarn thanyakij from Pexels)

Mengelola alokasi anggaran yang efektif juga bisa menjadi langkah menuju kesuksesan startup. Setiap hal tentu perlu dianggarkan sesuai rencana agar pengeluaran yang tidak terduga dapat dihindari oleh startup.

Misalnya, startup Anda memiliki kebutuhan untuk menskalakan kapasitas infrastruktur IT setiap enam bulan sekali. Maka, startup pun perlu merinci biaya yang akan dikenakan agar alokasinya dapat dibatasi dan diefisiensikan.

5. Kemampuan untuk beradaptasi dengan perubahan


(Source: Andrea Piacquadio from Pexels)

Startup yang sukses selalu bersedia untuk bisa beradaptasi dengan teknologi baru. Dengan melakukannya, startup akan menghasilkan inovasi yang baik dan mampu diterima oleh konsumennya. Selain itu, beradaptasi dengan memanfaatkan solusi teknologi juga dapat membantu bisnis untuk mempercepat laju kerja dan mengefisiensikan sumber daya yang ada. Dengan demikian, hal tersebut pun akan membantu pelaku usaha untuk mencapai kesuksesan startup yang diinginkan.

Itulah beberapa poin yang bisa Anda implementasikan untuk mencapai kesuksesan startup. Bila Anda memiliki pertanyaan lebih lanjut mengenai solusi cloud untuk startup, Anda dapat mengubungi kami di sini atau ke sales@zettagrid.id.